2026 年秋季学期,授课教师:Haipeng Luo
依据本地 lecture4.pdf(9 页)逐节完整翻译。保留定理、命题、引理及公式 (1)–(4) 的原编号和证明结构;图 1、图 2 提取自原课件。少量原文的简写、笔误及常数约定另以“译注”标明,不混入原论证。配套:详细讲解报告。
1 回归:Fat-shattering 维数
上一讲,我们利用不同的覆盖数,对实值函数类的 Rademacher 复杂度推导了几个上界,随后开始寻找一个类似于分类问题中 VC 维的组合参数,希望它能直接给出覆盖数的上界。第一次尝试是伪维数,定义为
也就是说,它是满足下述条件的最大整数 :存在 个输入输出对 ,使得对于任何标记 ,都存在 ,对所有 满足 。
对于线性类,这是一个合理的复杂度度量;但对可学习的单调不减函数类,它却是无穷大。事实上,对于任意 ,取输入输出对 。对任意标记 ,选择某个 ,总可以找到一个单调不减函数,经过
从而满足所有符号要求。因此,有限伪维数不是可学习性的必要条件。
比较伪维数与覆盖数的定义,可以发现前者缺少的是尺度 。直观上,我们需要一个依赖尺度的组合参数,并且尺度越大,它就越小。一种做法是要求诱导出的二分类器 不仅预测正确,还要以某个置信程度或间隔(margin)预测正确。这就引出了 fat-shattering 的概念。
具体地,如果存在 (称为打散的见证),使得对于任意标记 ,都存在 ,满足
就称 -打散了点集 。这个不等式恰好表示以至少 的间隔正确预测标签 。尺度 下的 fat-shattering 维数定义为最大可打散点集的大小:
显然, 随 单调不增:若能以尺度 打散某个集合,那么也能以任意更小的尺度 打散它。当 趋于零时,fat-shattering 维数就变为伪维数。
回到单调不减函数类。前面的构造只能保证 的间隔,随着 增大,间隔越来越小。若要求间隔至少为 ,该构造在 时仍成立,因此
当 时,这个构造不再有效。但这并不能证明 fat 维数恰好为 (想想为什么)。下面的命题说明, 确实给出了正确的阶。
命题 1。 设 、, 为所有单调不减函数组成的类。对任意 ,
证明。 假设 被 以尺度 打散,见证为 。对于每个 ,考虑满足 的标记,其余点的标记任意。由定义存在 ,使
由于 单调不减且 ,
于是 。累加得到
其中第一个不等式来自 。故 ,命题得证。
那么,fat-shattering 维数与覆盖数有什么联系?也存在类似 Sauer 引理的结论,这里只陈述而不证明。
定理 1。 对任意 、 和任意输入 ,存在绝对常数 ,使
这个上界比伪维数上界更紧,因为 。它还不依赖 ,粗略地说,意味着 位于 内某个“维数为 ”的空间中。应用 Dudley 熵积分,就能进一步得到 Rademacher 复杂度上界。例如,单调不减函数类满足下面的结论。
译注:“维数空间”是有效复杂度的直观比喻,不是线性子空间包含关系。若要把上式写成对整个 区间一致成立的常用形式,可把对数写作 ,其中 为常数,避免 时对数趋零。详细讲解采用这一写法。
命题 2。 对 、 上的所有单调不减函数类 ,
证明。 将
代入 Dudley 熵积分,得到
上一讲通过 覆盖数上界 ,得到了 的复杂度界;这里利用 fat 维数直接控制 覆盖数,进一步去掉了根号中的 因子。这展示了直接使用 fat-shattering 维数的优势。
事实上,与伪维数不同,有限 fat-shattering 维数已被证明是 可学习的必要条件。综合起来,我们得到统计学习博弈值的一串紧上界:
译注:这里“有限”指每个固定正尺度上的维数有限。必要性要放在相应实值学习问题和损失假设下理解,不能推广到任意损失(例如恒零损失)。 是损失对预测值的 Lipschitz 常数;所需可测性、可积性与前几讲相同。
2 理解神经网络的复杂度
到这里,我们已经介绍了理解统计学习所需的基本概念和工具。现在以神经网络为案例,看看这些理论能否至少部分解释它在实践中的成功。
神经网络的一大谜题是:即使参数数量比训练样本量大好几个数量级,它们为什么仍能泛化?现代网络可以轻易拥有数百万乃至数十亿个参数,表达能力很强,往往能取得零训练误差。要让训练集上的好表现推广到未见数据,理论提示我们研究一致收敛,或更一般地研究对应函数类的可学习性。
分类问题的可学习性可用 VC 维刻画。但神经网络的 VC 维似乎常常至少与样本量一样大。例如,一个约有一百万参数的全连接前馈网络,能够完美拟合含五万张图片、标签完全随机的 CIFAR10;这为模型类能够打散 CIFAR10 提供了有力证据 [Zhang et al., 2017]。从
这样的理论界来看,我们不应期待该类有很好的泛化保证。可是,同一个网络在干净的 CIFAR10 上训练,却能达到约 50% 的准确率;对于十分类问题,这已明显优于随机猜测。参数量相近的卷积网络甚至可以达到接近 90% 的准确率。
其他复杂度量似乎也遇到了困难:即使在线性函数类这个神经网络的退化特例中,前面推导的超额风险界也形如 ,其中 基本就是参数个数,而训练神经网络时常有 。难道前面学到的理论完全没有用吗?
并非如此。这只说明 VC 维或参数个数很可能不是衡量网络内在复杂度的合适量。直观上,权重的大小应该起到更重要的作用。我们在 HW1 中已经见过例子:当线性函数权重满足 时,Rademacher 复杂度至多为
它不显式依赖维数,说明真正影响复杂度的是权重范数,而非向量的维度。
下面主要沿用 Bartlett et al. [2017] 的思路:先为线性类推导几乎不依赖维数的覆盖数界,再推广到对应单层网络的矩阵情形,最后推广到完整网络。理论推导之后,我们再回到实验结果,讨论新上界是否解释了神经网络的实践表现。
译注:较大的最坏情形上界只是无法提供有效保证,并不证明某个数据分布上的实际泛化一定很差;拟合若干随机标记也不是“拟合全部标记”的形式证明。CIFAR10 是多分类问题,原文在这里借用二分类 VC 维作直观讨论。
2.1 几乎不依赖维数的覆盖数:热身
先证明一个在线性类上成立的对数覆盖数上界(HW1 中已出现)。它对 的显式依赖只有对数级。
定理 2。 对函数类
有
其中 以 为各行。
相比之下,上一讲在 下得到了
它对 是线性依赖。新上界对 的依赖虽然更差,但得益于 Dudley 积分,最终并不会改变 Rademacher 复杂度关于 的主要速率。在 HW1 中,需要由此证明忽略对数因子后的 上界;它仍是 阶,却没有维数的多项式依赖。
为证明定理 2,回顾 HW1 中证明的结论。
引理 1。 设 是 维欧氏单位球中的点,且
则 。原文称 为这些点的凸包经 缩放后的集合。
译注:由于系数和允许小于 ,严格地说 。一般有限采样证明应保留向上取整及零原子,例如 。原文省略了这些细节,定理 2–4 的精确常数也应结合这一约定理解;它们强调的尺度与维数依赖不受影响。
定理 2 的证明。 每个样本投影向量都是 。令
则 ,并且 。不过 可能为负,与引理 1 的条件不一致。可以写成
因此只要把基向量数从 加倍为 ,使用 ,即可让系数非负。再由 Cauchy–Schwarz 不等式,
应用引理 1 即得结论。对于其他原始范数与对偶范数对,也可用同样论证证明类似结果,这里不再展开,读者可以尝试。
译注:若某列 ,直接删去该零原子,避免除零。这里需要的是投影集合包含于相应缩放凸包,不要求二者相等。
2.2 几乎不依赖维数的覆盖数:单层网络
考虑单层神经网络:通过 和逐坐标 ReLU 激活 ,将 映射到 。一维 ReLU 定义为 。我们关心 混合范数
即先求每列的 范数,再对这些数求 范数。原因将从证明中自然出现。
定理 3。 对
有
证明。 每个投影是 。ReLU 为 1-Lipschitz,因此只需覆盖线性集合 。展开
其中
将每个矩阵原子视为 维向量,就可应用引理 1:引理中的 换为 ,原子数换为 ,因子 2 同样来自正负系数。只剩计算系数总量:
这里再次使用了 Cauchy–Schwarz 不等式。应用引理 1 即完成证明。
这个界对参数个数 的依赖仍很弱。 混合范数是在分析过程中自然出现的。Bartlett et al. [2017] 用略有不同的方法计算 ,得到与 的 混合范数有关的上界:
因为总有 (两边平方后使用 Cauchy–Schwarz 即可证明),这里的结果看起来比 Bartlett et al. [2017] 略有改进。
2.3 几乎不依赖维数的覆盖数:多层网络
下面推广到一般全连接前馈多层神经网络。先建立记号。
- 总层数为 ,第 层从 映射到 ,其中 ,并记 。
第 层的权重属于 ,。 是谱范数。
用 表示下面定义的前 层网络类。最终关心的是 。
- 对 和 ,用 表示 的最小 -覆盖。由定理 3,
不失一般性,假设覆盖中心也属于上述被覆盖的集合;原文脚注指向 HW1 第 3(a)i 题。
译注:这里的 是归一化距离 下的半径,等价于未归一化 Frobenius 半径 。原文称它“相对于 Frobenius 范数”的表述容易混淆。把外部覆盖中心移入集合一般需要半径加倍,不能无条件保持同一精确常数;后续按原文简写记录,详解给出常数修正。
递归定义
每个 都可写成 ,其中 。因为 、ReLU 为 1-Lipschitz,且 ,
递归应用可得 ,因此
下面证明每个 确实覆盖 ,二者都是 的子集。
引理 2。 对每个 , 是 的 -覆盖,其中
证明。 对 归纳。 时,,且 ,由定义成立。一般地,假设结论对 成立。对任意真实网络的前 层输出
归纳假设保证存在 ,使
再由 的定义,找到 ,使
令 。合并可得
各步依次使用三角不等式、式 (3) 与 ReLU 的 Lipschitz 性、谱范数性质、式 (2) 与权重约束。归纳完成。
适当设置 ,便得到主要定理。
定理 4。 对 层网络类 ,
译注:定理 4 的 在这里指沿用前文的归一化 /Frobenius 覆盖数。
证明。 引理 2 给出
现在在约束
下选择 ,使该上界最小。用概率向量 分配最终总误差:第 层承担的最终误差为
将 代入,得到
只剩在 下最小化最后一项。KKT 条件给出最优 ,最优值为
最后写成 ,即得定理。
由于对 的依赖仍是 ,与线性情形相同,利用类似 HW1 第 1(b) 题的计算可知,复杂度的主要量级为
除对数因子外,这再次没有显式的参数个数依赖。于是对权重 ,定义其谱复杂度为
2.4 用谱复杂度与 margin 解释神经网络的泛化
前面的推导提示,网络的泛化与谱复杂度有关,而不仅是参数个数。下面讨论 Bartlett et al. [2017] 的实验。
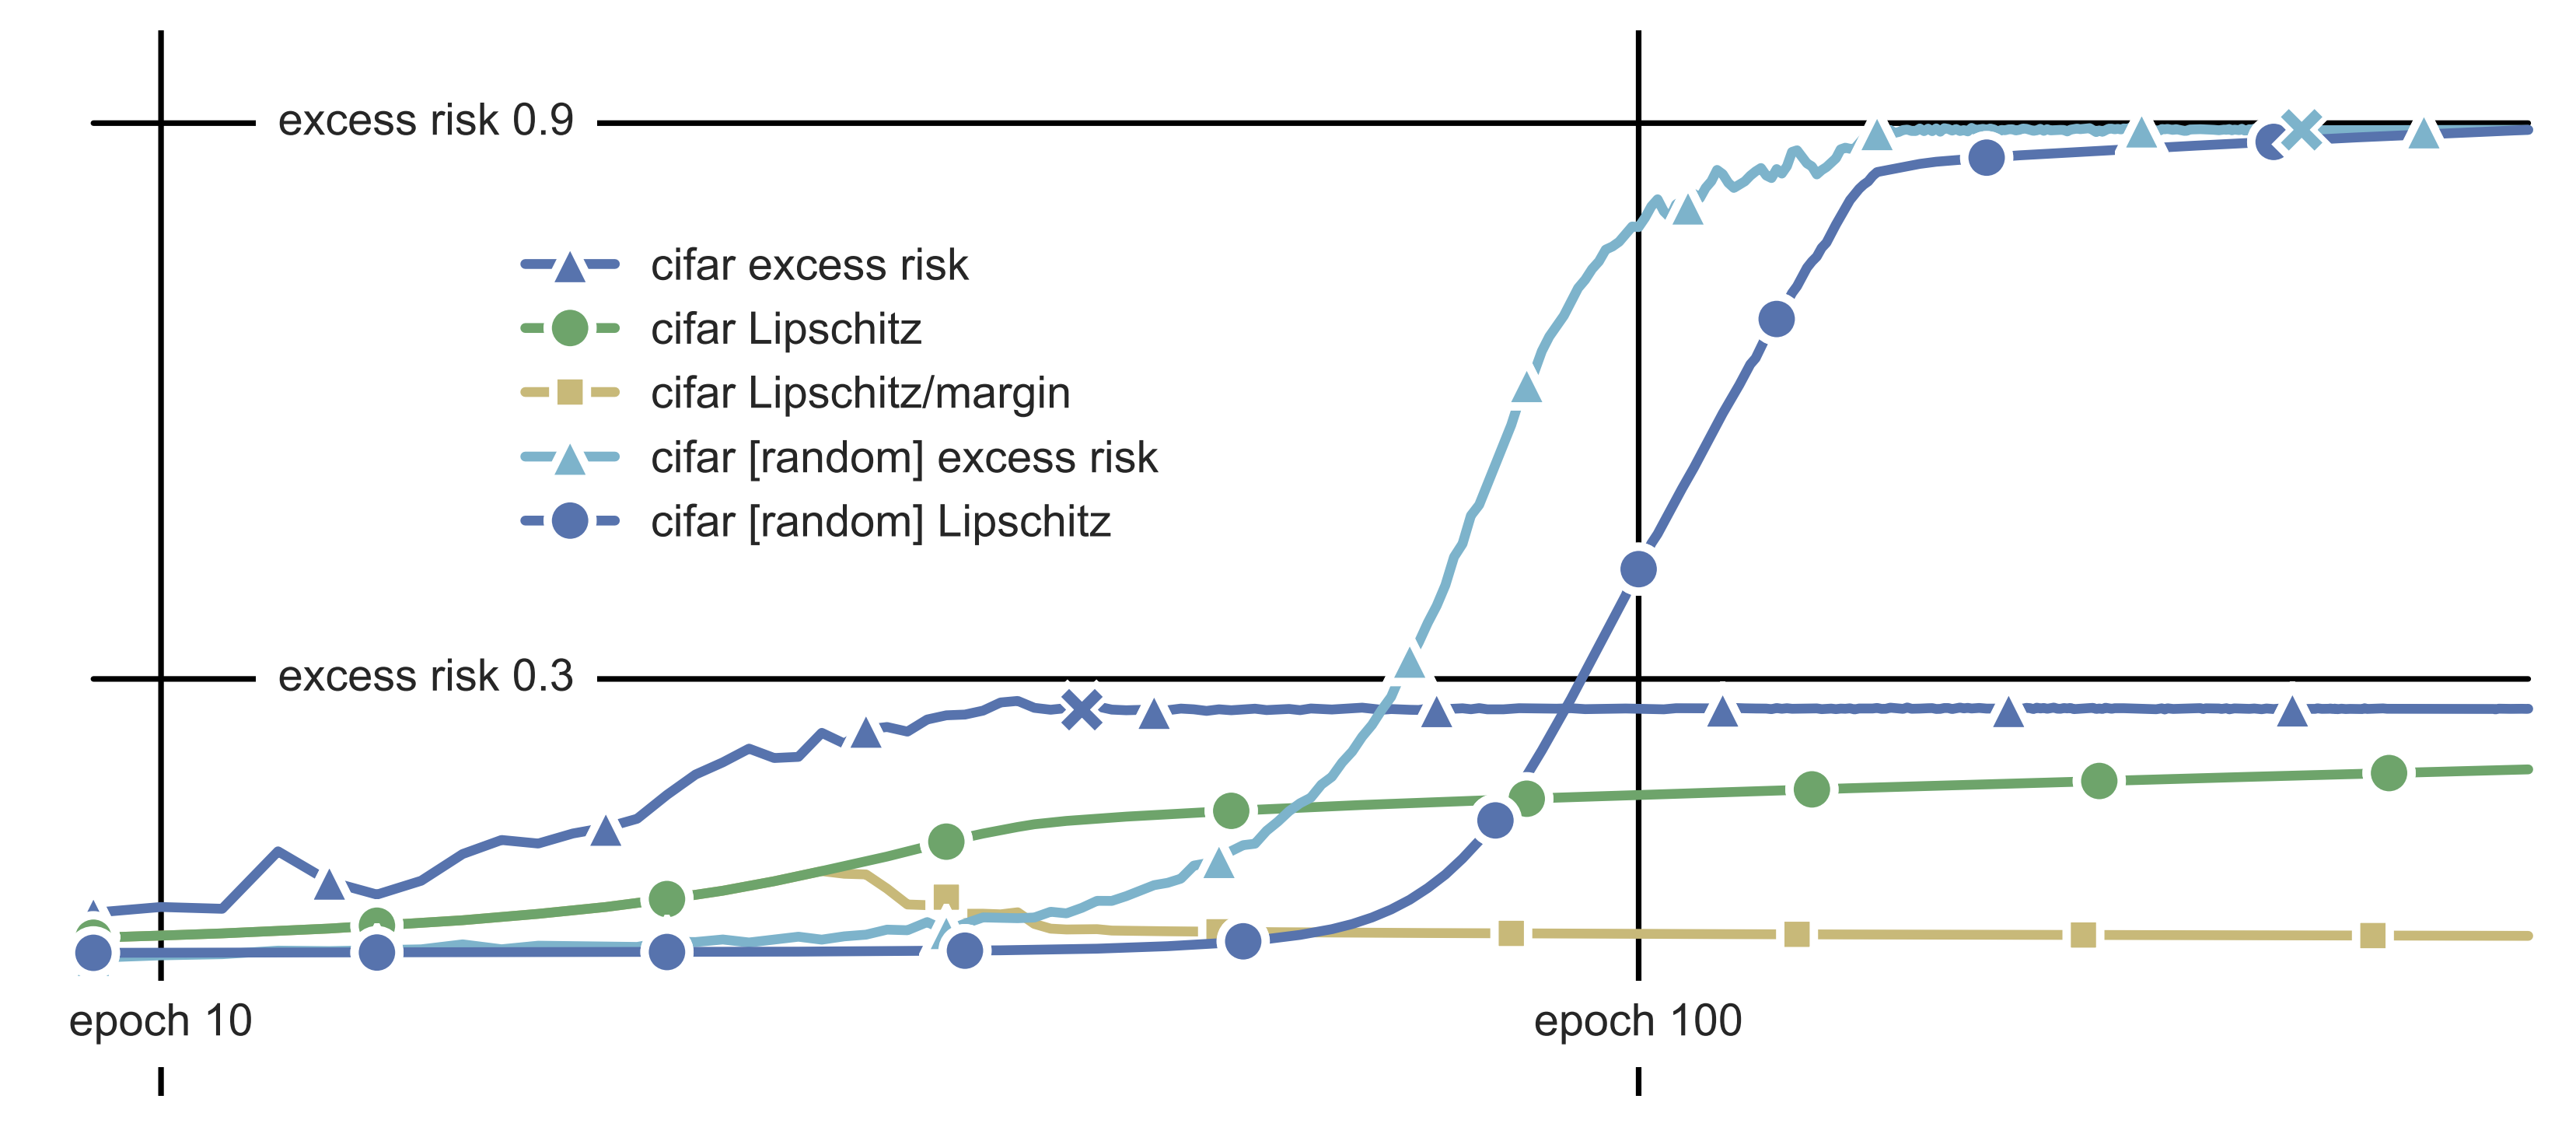
图 1。 在 CIFAR10 上训练 AlexNet 的实验结果:原始标签与随机标签。
图中展示了训练轮次增加时,“excess risk”和“Lipschitzness”的变化。这里 excess risk 实际指测试误差减去训练误差,即泛化间隙,因此它通常随训练上升。原课件把 Lipschitzness 描述为与谱复杂度相差常数的量。叉号标出训练误差首次达到零的时间;原始标签时明显早于随机标签。在此之后,泛化间隙就是测试误差:原始标签下约稳定在 0.3,随机标签下约稳定在 0.9。
两种实验的参数个数相同,无法解释泛化的巨大差异;复杂度曲线则与泛化间隙相关,原始标签下明显更低,说明它提供了更有区分能力的复杂度信息。
译注:原论文把图中 Lipschitz 曲线解释为谱范数乘积,完整谱复杂度还带混合范数修正因子;一般不能把二者视为只差固定常数。图像原样保留,详解区分二者。
Margin。 更细看图,泛化间隙稳定后,复杂度仍在增长,所以仅有 的界还不能完全解释现象。论文进一步使用 margin 衡量预测置信程度:训练误差归零后,网络的复杂度可能继续增加,但对预测也变得更有把握。
网络 通过 预测类别。定义样本 的 margin 为
正 margin 表示预测正确,负 margin 表示预测错误;正 margin 越大,预测越有把握。结合前述结果和其他标准工具,论文证明,以高概率,对任意网络 和任意 ,
控制两项的权衡:第一项随 增大而增大,第二项随之减小。由于该界同时对所有 成立,可以选择权衡最好的值。这是分析中的选择,不是训练算法的超参数。
当训练误差为零时,可取训练集上的最小 margin,,得到
即使谱复杂度继续增加,只要 margin 也相应增加,泛化误差就不一定上升。图 1 的方块曲线展示了除以 margin 后的复杂度,它确实趋于稳定。
译注:margin 为零时涉及平局规则,零训练误差不自动保证 。式 (4) 是课件的主要量级简写;完整高概率界还包括置信项,原论文使用的混合范数形式也不同。若使用 的端点约定,可取 。
Margin 分布。 对 margin 适当归一化并观察经验分布,可以定性比较任务难度,如图 2。每条曲线对应某个任务中训练的 AlexNet,其 margin 被 归一化。因为式 (4) 可等价改写为
所以分布的累积分布函数 CDF 对应右侧的第一项。原文这一改写公式的左侧把 误写成了 ,此处已明确更正。
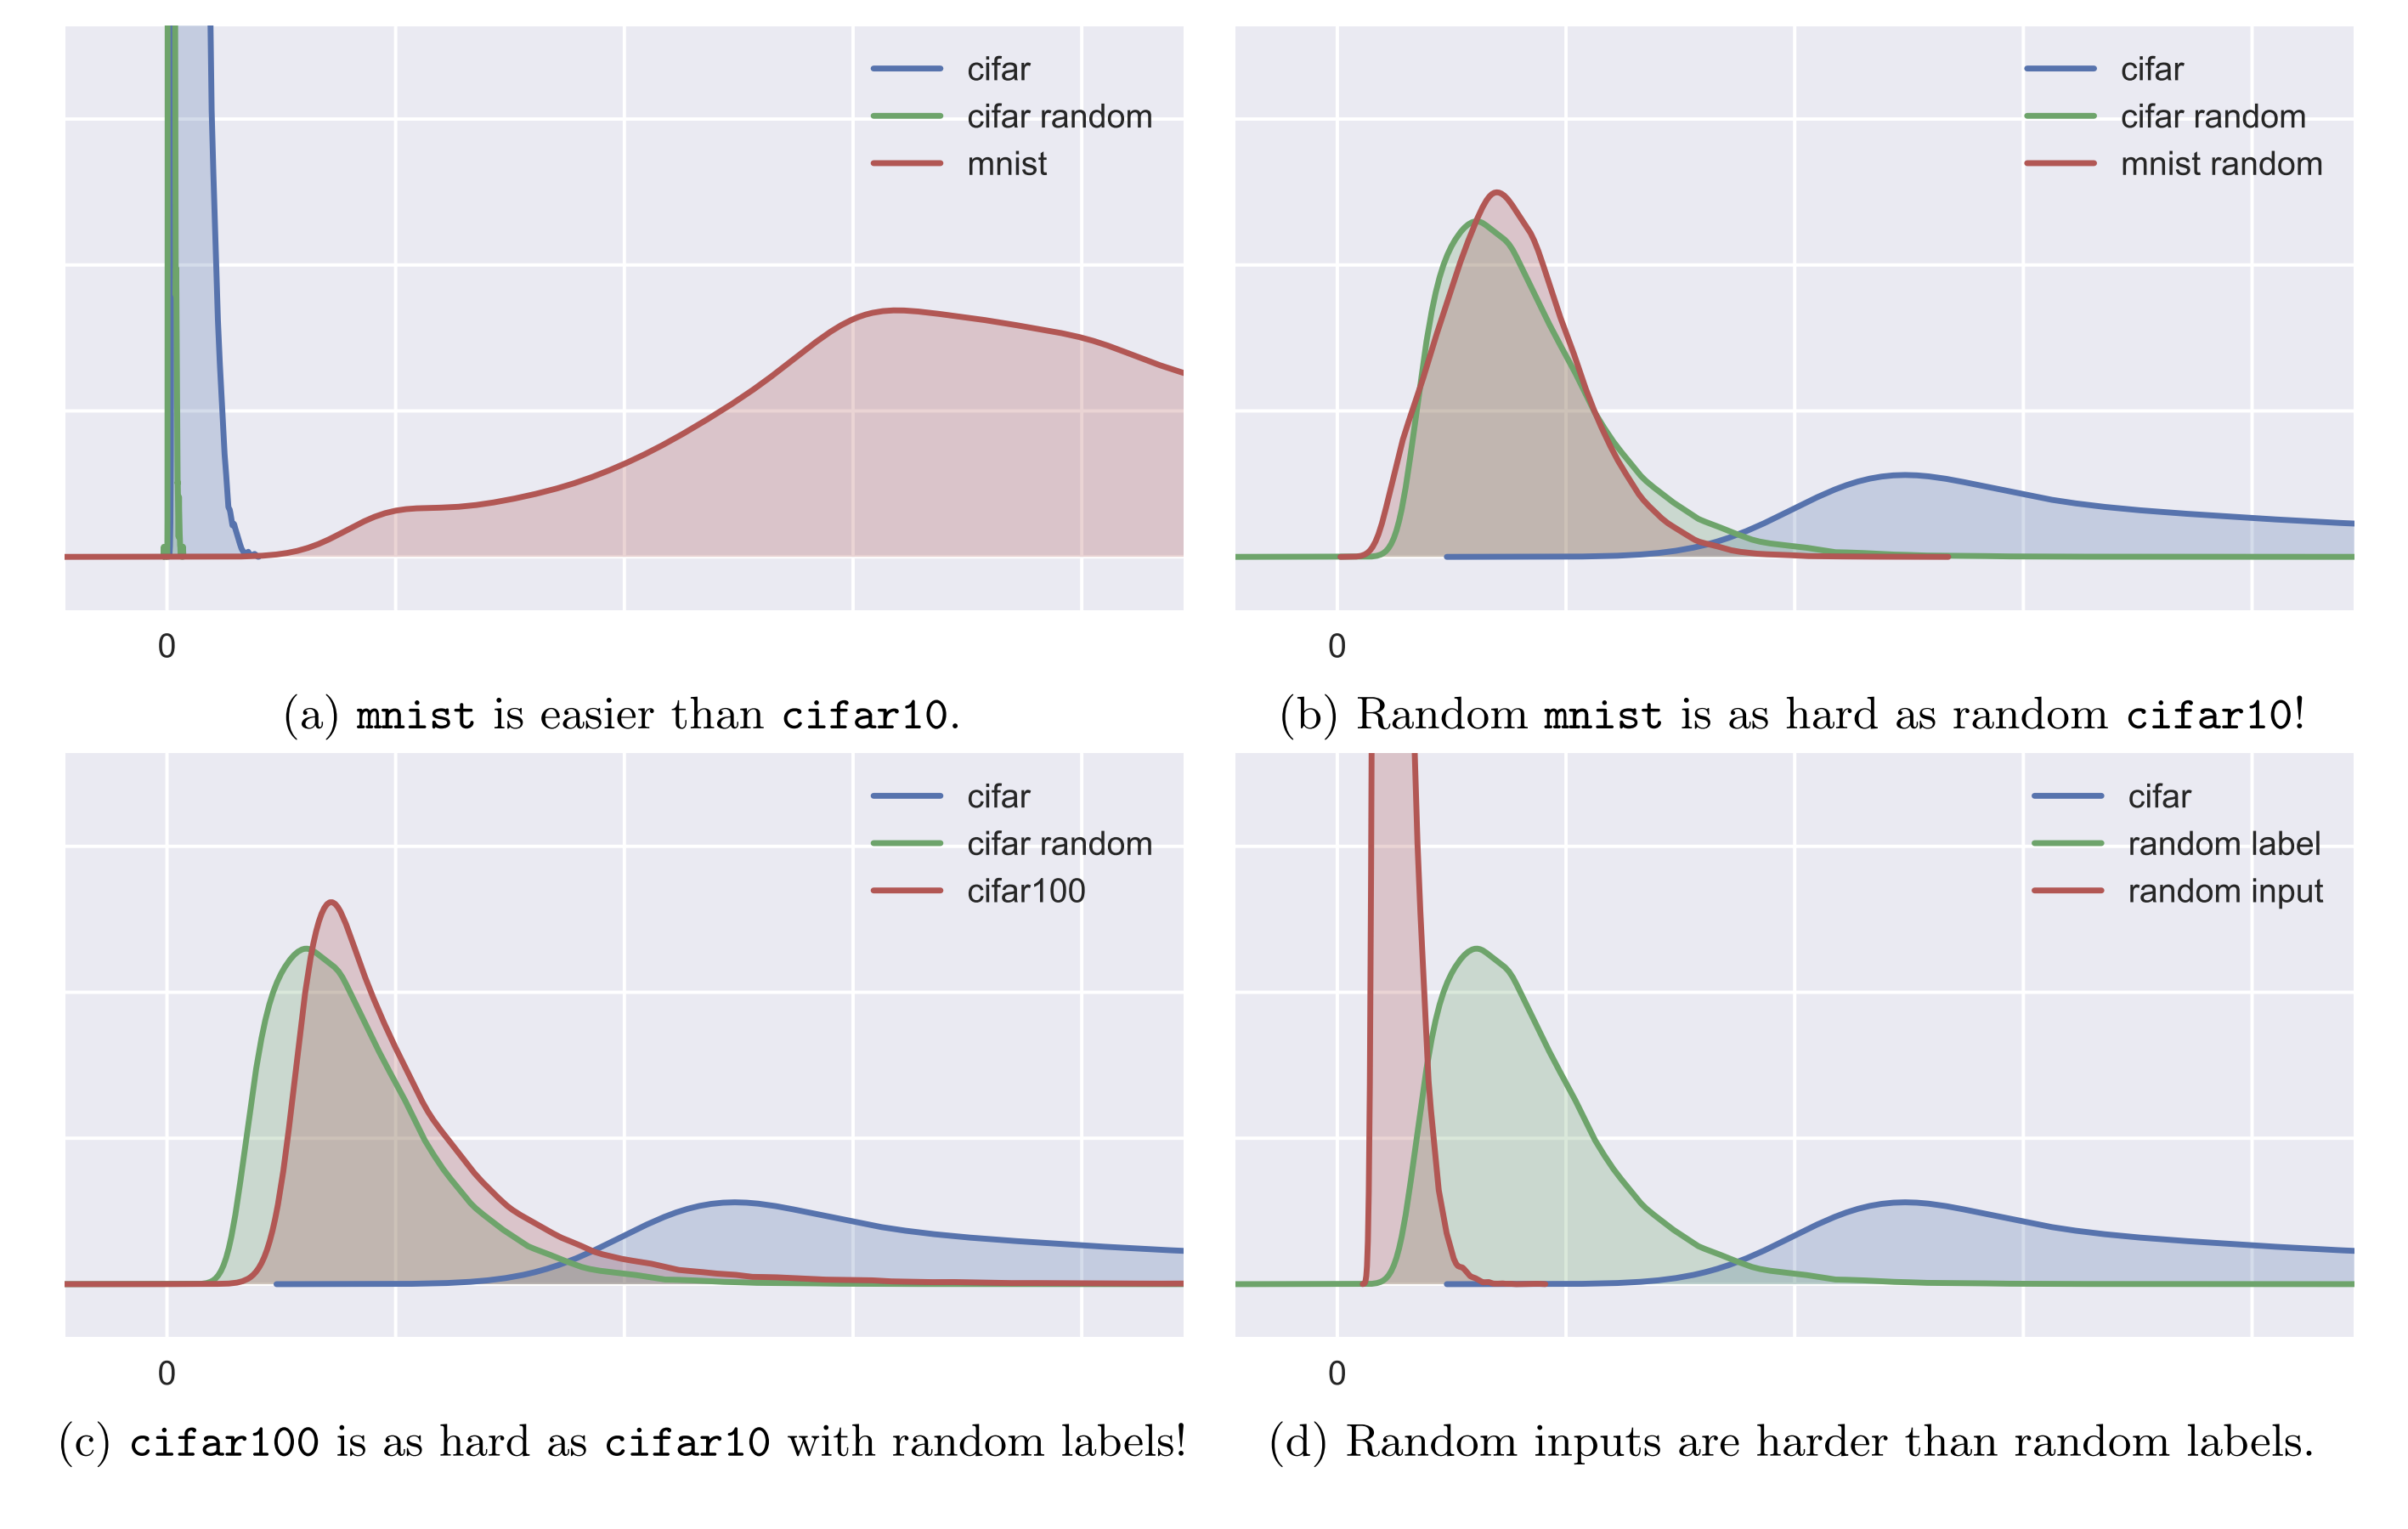
图 2。 比较不同任务的归一化 margin 分布。
分布越偏右,对应任务在这一指标下越容易。图 2 表明:(a) MNIST 比 CIFAR10 更容易;(b) 加上随机标签后二者几乎一样难;(c) 有 100 个类别的 CIFAR100,与带随机标签的 CIFAR10 几乎一样难;(d) 随机输入比随机标签还难。
结束语。 我们用谱复杂度和 margin,对参数量远大于样本量的神经网络仍能泛化给出了合理解释。但我们完全没有回答:为什么在干净数据上训练的网络往往具有较低谱复杂度?训练通常不是在某个固定谱复杂度约束类内做 ERM,而是在没有显式权重范数约束的情况下运行 SGD 的变体。这属于本课程暂时忽略的非凸优化问题;理解 SGD 为什么隐式偏向低复杂度网络,是一个研究方向。
参考文献
- Peter L. Bartlett, Dylan J. Foster, Matus J. Telgarsky. Spectrally-normalized margin bounds for neural networks. Advances in Neural Information Processing Systems 30, 2017.
- Chiyuan Zhang, Samy Bengio, Moritz Hardt, Benjamin Recht, Oriol Vinyals. Understanding deep learning requires rethinking generalization. International Conference on Learning Representations, 2017.