整理 B 站《5 分钟学会架构设计》的报名案例笔记时,我最初的理解是:容易变化的层,应该依赖不容易变化的层。所以 API 和 DB 在外侧,service 负责流程,domain 放业务规则。
但我卡在了“业务规则比较稳定”这里。产品调整报名资格、价格或者审批流程,改的恰好就是 domain 和 service;数据库和 Web 框架倒可能几年都不换。照修改频率来排,业务层反而最不稳定。
那这套依赖方向还成立吗?而且,一个本来几十行就能写完的报名功能,拆出这么多文件和接口,究竟省了什么工作?
带着这两个疑问,再看依赖倒置和接口,事情就具体多了:规则可以经常改,调用它的代码却未必需要跟着改。下面仍用报名来讨论,适用规模和工程成本的部分是我在案例基础上的延伸。
从一个报名函数拆出四种职责
报名功能可以直接写在一个函数里:解析请求,查询学生和课程,检查重复报名和容量,保存,再返回 HTTP 响应。
麻烦出现在修改的时候。只想确认“满员后不能报名”这一条规则,也得读过查询语句和 HTTP 异常处理。测试还可能先要准备数据库连接。
案例按下面的方式拆开了这些代码:
| 部分 | 核心问题 | 报名例子 |
|---|---|---|
| domain | 业务上哪些行为合法? | 不允许重复报名,不允许超过容量 |
| service | 完成一个用例需要安排哪些步骤? | 获取数据、执行报名规则、保存结果 |
| API | 外部如何发起操作、理解结果? | 解析参数,把业务结果转换成 HTTP 响应 |
| DB 实现 | 数据具体如何读取和持久化? | SQL、ORM、字段映射和存储操作 |
这里的 service 是应用里的用例编排代码,不需要单独部署。domain 也可以写成普通函数。把报名行为放进 Course 对象,适合这个案例,但不必把所有行为都塞进类里。
至于到底分几层,Clean Architecture 的原文说得很清楚:图中的层数是示意。照着建四个文件夹,并不能保证职责已经分开。
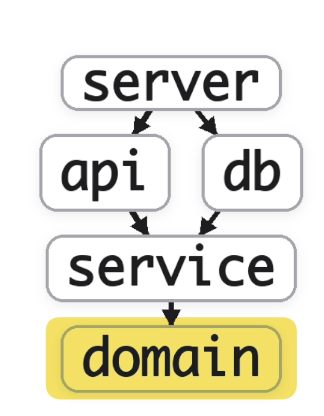
图 1:原视频报名案例的分层示意。server 是组装入口,负责创建对象、接好依赖并启动应用;黄色部分是领域规则。db → service 简写了“DB 实现业务侧的存储接口”这层关系。箭头表示代码依赖,不能把它当成请求执行顺序。
“稳定”至少有三种含义
我最初把“稳定”理解成了代码改得少。这个理解漏掉了调用者。
一个资格判断函数,内部条件每周都改,但参数、返回结果和失败方式没变,调用者就可能完全不用动。这是实现经常变化、对外契约相对稳定。这里的契约包括怎么调用、会怎样失败、能保证什么,不能只看函数签名。
还有一种稳定,是不受无关变化影响。报名资格会随产品决策调整,但升级 HTTP 框架不该改变报名资格。这才是把业务规则放在内侧时,希望得到的隔离效果。
反过来看,一个模块一年没改,如果把内部数据结构全暴露出去了,调用者仍然会和它绑得很紧。数据库产品多年不换,查询、表结构、索引和事务代码也可能一直在调整;同一个 API 框架下,对外接口照样会变。
所以,代码改得少、调用者不用改、不受某类变化影响,是不同的事。只统计 Git 提交次数,回答不了谁应该依赖谁。
依赖倒置改变的是代码依赖
service 要读取课程,运行时当然还是会调用存储对象。依赖倒置处理的是源代码中的关系:service 是否必须引用那个具体的 PostgreSQL 存储类?
可以由业务侧定义一个 EnrollmentStore 接口,说明自己需要读取什么、保存什么。service 使用这个接口,PostgreSQL adapter 负责实现它。这样,写报名流程时就不需要直接引用 PostgreSQL 的实现。
图 2:源代码依赖。实线表示使用,虚线表示实现接口;箭头都指向被依赖的部分。查看大图 · Mermaid 源文件
这也解释了原图里容易误读的 db → service:DB 实现依赖业务侧声明的接口,并不是数据库主动发起对 service 的调用。
到了启动程序的时候,再创建具体的存储对象,把它传给 service,让 API 使用这个 service。这就是依赖注入。用构造函数参数或者普通函数参数就能做到,不一定需要一个容器。
图 3:一次报名成功的调用顺序,从上到下读。service 通过注入的对象调用 DB 实现,源代码里引用的仍然可以只是接口。图中省略了失败分支;事务和并发问题还需要另外处理。查看大图 · Mermaid 源文件
不过,加上接口不代表细节就藏好了。如果调用者还要传 SQL、管理 ORM session、处理数据库行对象,理解报名流程时依然绕不开存储实现。这样的接口省不了多少事。
domain 变化最快时,架构仍然可能有效
回到最初的疑问。假设报名操作长这样:
enroll(student_id, course_id) -> EnrollmentResult产品把“开课前允许报名”改成“开课前 24 小时截止”。如果数据里已经有开课时间,已有失败结果也能表达这次拒绝,修改资格判断和对应测试就可能够了。
service 仍按原来的步骤执行,API 继续接收两个 ID,数据库也不用多读字段。domain 确实改了,但它的调用者不一定需要改。
这也是我觉得分层值得考虑的地方。既然截止时间经常变,就把时间判断放在一个容易找到、容易测试的地方。改这条规则时,不必再准备一整套 HTTP 请求和数据库连接。
Cockburn 在六边形架构的原文中讨论的,正包括让应用脱离具体 UI 和数据库测试,以及让程序、批处理等不同入口调用同一套应用能力。
但如果产品要把“立即报名成功”改成“先付款,再审核,最后确认”,需要动的地方就多了:
- domain 增加待付款、待审核等状态及转换规则。
- service 编排付款和审核流程。
- DB 保存新增状态和记录。
- API 暴露相应操作,返回新的结果。
这次四层都改,并不奇怪。“报名成功”本身的含义变了,调用者和存储自然可能需要配合。为了保住某个旧接口,硬把新流程塞进去,反而会让代码难懂。
要分清的是,这些修改是新业务确实需要的,还是一个地方暴露了太多内部细节,导致别处被迫跟着改。
图 4:同样是产品改需求,影响范围可以差很多。左边的前提是已有数据和结果足够表达新规则;右边增加了业务状态,需要各层配合。查看大图 · Mermaid 源文件
将经常变化的规则收拢到更小的范围
假如普通课程、会员课程和活动课程的资格不同,但报名步骤差不多,我会先把资格判断提成一个函数。流程拿到“允许”或者“拒绝及原因”,继续往下走就行。
等到多套规则确实需要切换、分别维护,再考虑策略接口。眼下只有一个条件,就先把这个条件写清楚。为了它搭一套通用规则引擎,后面很可能还得维护规则引擎本身。
产品还在探索时,规则可能整套推翻。这种时候我更愿意让模型简单一点,留出重写的余地,先不猜未来所有需求。
至于 API 和 DB 一直没变,也没关系。分层如果让日常修改和测试轻松了,就有用;连这点收益也没有,就很难只凭“将来可能换数据库”说服自己多写一套接口。
需要多大的业务,才值得这样拆分?
我不太能给出“几万用户以后就该分层”这样的答案。用户数和代码的维护难度,并没有那么直接的关系。
一个访问量很大的查询服务,可能没多少业务规则。一个只有几百人用的结算系统,金额和审批状态却可能非常难处理。前者首先要解决吞吐量,后者即使流量很小,也得把规则理清楚。
比起规模数字,我会先看这些麻烦有没有出现:
| 已有问题 | 值得考虑的拆分 |
|---|---|
| 同一规则在 HTTP、定时任务和导入脚本中重复 | 将共同业务能力集中到可复用的用例或规则模块 |
| 验证一个计算或资格判断必须启动整套服务 | 分离纯规则与外部交互 |
| 改一个条件要同时理解请求、ORM 和 SQL | 收拢规则,缩小维护者需要掌握的范围 |
| 相同状态和金额规则散落多处,修改经常遗漏 | 明确规则的唯一维护位置 |
| 一次需求经常触发无关模块返工 | 检查共享数据结构和实现细节是否泄露 |
这些麻烦出现得多不多、几个人需要一起改、项目还要维护多久,都会影响这笔投入值不值。临时工具和长期维护的产品,没必要按同一个标准拆。
同一个项目里也可以区别对待。报名流程已经很复杂,就给它独立的规则和存储接口;旁边的只读列表直接查询返回,也完全说得通。
收益与代价,都发生在日常维护中
分层能省下的工作,往往很普通:改资格条件时不用找几个副本,测一条规则时不用启动整套服务。将来增加批量导入,如果可以直接调用已有报名逻辑,也就少了一份需要长期同步的代码。多人协作时,知道一个模块接受什么、返回什么,通常比先读懂它全部实现更省力。
但多出来的东西也得有人维护。接口要命名,对象要组装,数据在几种模型之间来回转换;读一个功能,要跳过更多文件。接口设计得不合适,新增一个字段就可能变成五层一起改。
比如下面这条调用链:
Controller -> Service -> Repository -> ORM如果每层都在处理自己的规则或转换,这样写没什么问题。但如果参数原样传下去,结果原样传回来,最后还是要读 ORM 那一层才能明白发生了什么,中间这些转发就值得再想想。
我会试着问:删掉这一层后,原本由它处理的事情会不会散到几个调用方里?如果会,它确实省了重复工作。如果删掉以后只少跳一个文件,那就未必需要保留。
收益有多大,只能结合实际需求算。经常发生的修改,每次省一点时间,积累下来可能很可观;少一次漏改或者跨团队来回确认,也有价值。另一边是最初拆分的时间,以及以后每次维护接口和数据映射的时间。
与其给架构打一个通用的收益分数,我更愿意拿最近几次需求试算:按这套拆法,当时能少改哪里,又会多做哪些工作?
报名案例还隐藏着两个现实成本
换数据库不只是修改一行组装代码
案例里“换数据库只改组装处一行”很直观,但那是新实现已经写好、也满足原有契约之后的最后一步。
真正从 SQLite 迁到 PostgreSQL,SQL 方言、历史数据、事务隔离和性能都可能需要处理。接口能让报名逻辑少改一些,这些迁移工作仍然在。
所以我不会把“以后能换数据库”当作唯一理由。当前有没有测试、维护或复用上的需要,更容易判断。
规则正确,不代表并发下仍然正确
课程只剩一个名额时,两个请求可能同时读到“还有空位”,通过各自的 domain 检查,然后都保存成功。规则单独看没错,课程还是超额了。
要防止这种情况,可能需要在事务里加锁、更新时检查版本,或者把容量条件放进原子写入。重复报名则可以再由合适的唯一约束防住。
这些事得一起设计:报名操作要求哪些步骤要么一起成功、要么一起失败,存储实现如何保证,失败后流程又该怎么处理。接口如果只写了 get 和 save,却没说明一致性要求,就把一个实际问题留给了使用者。
纯规则测试能检查资格判断。数据库集成测试和必要的并发测试,要确认真实存储也守得住这些要求。内存替身跑通了,不能替代后面的验证。
从小项目开始,逐步增加结构
如果从一个小项目开始,我会先让路由处理 HTTP,用业务函数把一次操作写清楚,需要时直接调用 ORM。简单 CRUD 没必要给每张表都配齐 domain、service 和 repository。
Fowler 所说的 Transaction Script,就是用一个过程处理一次业务请求,把公共步骤提出来。这是可以认真采用的起点。
当资格判断和状态转换开始难读、难测,再把这些规则提出来。先用函数也行;等一组数据和行为确实需要放在一起维护,再考虑更丰富的对象模型。
接口也可以晚一点加。如果真实数据库让规则测试很麻烦,或者支付、通知已经有不同实现,就在这些地方留下替换的位置。测试替身算一个实际用途,只是不能因此省掉对真实实现的集成验证。
业务继续增长时,我会按报名、支付、课程来组织模块,让它们各自决定内部需要分几层,而不是让所有功能挤进一个越来越大的 service。
做到这里,应用仍然可以只有一个进程。要不要拆微服务,还得另外算网络调用、部署运维和跨服务一致性的成本。
让每一层说明自己减少了什么成本
我现在更关心下一次改需求时的情形。截止时间又改了,能不能找到那条规则,改完就跑它的测试?如果要加付款和审核,哪些地方确实要一起动,接口有没有把这些要求说清楚?
domain 和 service 经常变化并不让我觉得分层失效。让我犹豫的是另一种情况:多写了一堆接口,每次修改却仍要从头读到尾。遇到这种设计,我会先试着合并那几层只有转发的代码,再看还剩下哪些事情值得单独处理。
参考资料
- B 站《5 分钟学会架构设计》:课程报名案例,本文从这段视频的总结笔记出发。
- Robert C. Martin:The Clean Architecture:职责分离、源代码依赖方向与内外层交互。
- Alistair Cockburn:Hexagonal Architecture:端口与适配器,以及应用脱离 UI 和数据库进行测试的动机。
- Martin Fowler:Transaction Script:按业务请求组织过程式逻辑的方式。